Grundlegende Daten
Mehrsprachige und multimodale Text-, Sprach- und Bilddaten, die speziell für das grundlegende Training von KI entwickelt wurden.
Capturing the Real World Data AI has been Missing.
Mehrsprachige und multimodale KI-Trainingsdaten, die von menschlichen Experten überprüft wurden, um die Leistung von LLMs zu optimieren. Diese Daten werden durch eine fünfstufige Qualitätspipeline kontinuierlich verfeinert und garantieren eine Genauigkeit von 99,8 % bei zu 100 % urheberrechtlich geschützten Daten.
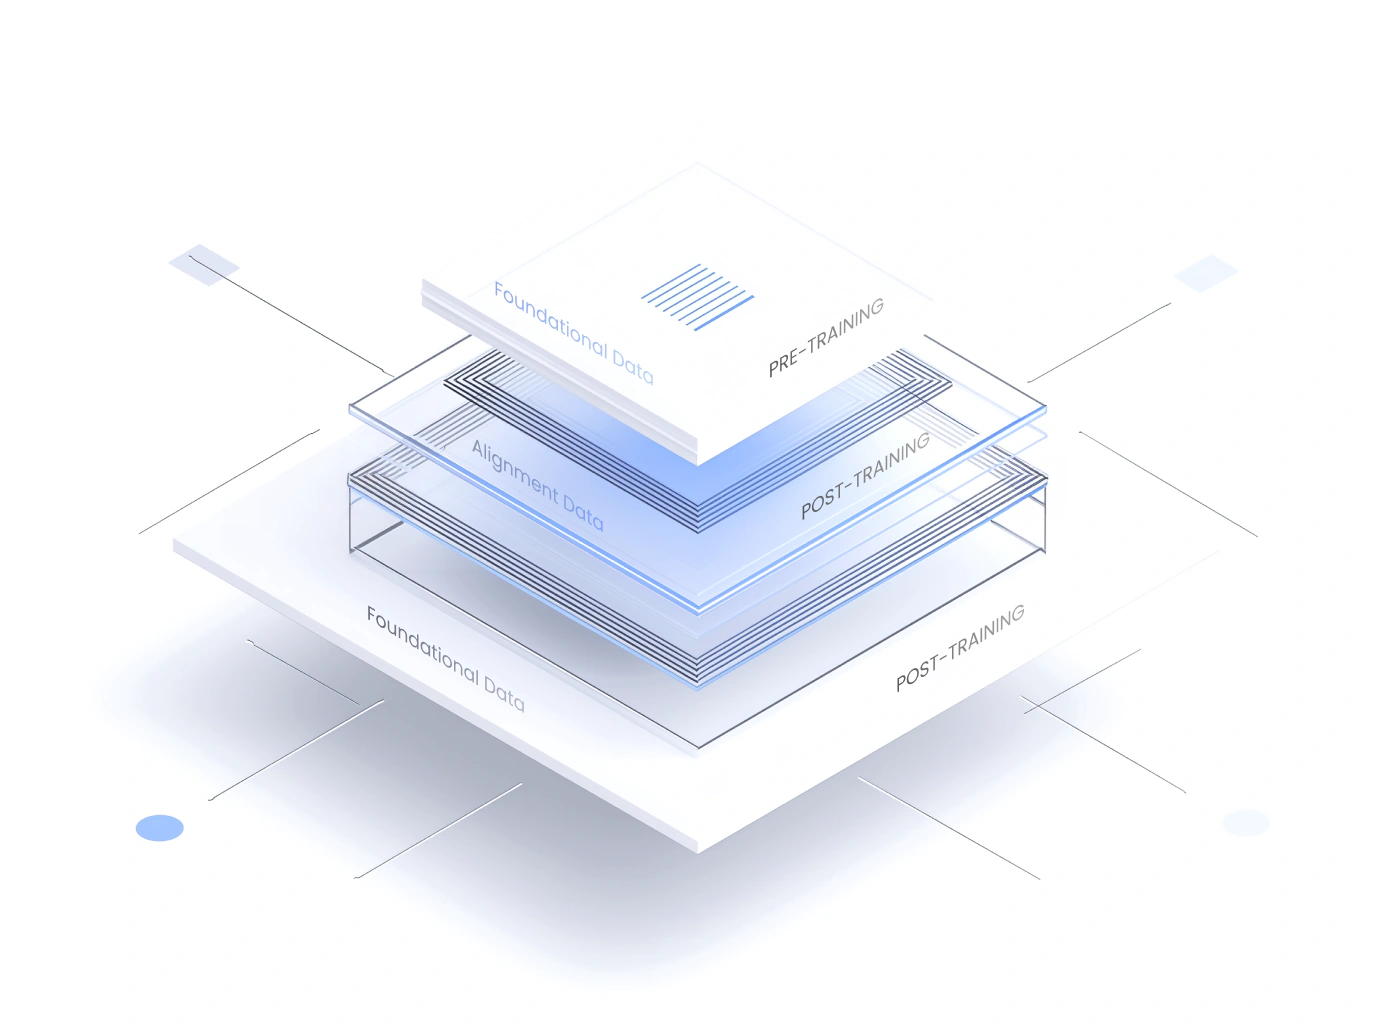
Flitto treibt die Entwicklung der KI als mehrphasige, multimodale und mehrsprachige Plattform voran – sie unterstützt jede Phase der KI-Pipeline, verarbeitet nahtlos verschiedene Datentypen wie Text, Bilder, Audio und Video und ermöglicht es KI-Modellen, in allen Sprachen und auf den globalen Märkten leistungsfähig zu sein.


Von den Daten vor dem Training bis hin zu den Daten nach dem Training
Mehrsprachige und multimodale Text-, Sprach- und Bilddaten, die speziell für das grundlegende Training von KI entwickelt wurden.
RLHF, mehrrundige Dialogen und Sicherheitsdaten, die auf menschliche Absichten und Werte abgestimmt sind.
Modernste Benchmark-, CoT- und Codierungsdatensätze, die darauf ausgelegt sind, die Grenzen innovativer KI-Modelle zu erweitern.
Flitto arbeitet mit Experten aus verschiedenen Fachbereichen zusammen, um Trainingsdaten für KI zu erstellen und zu sammeln, und stellt dabei sowohl abgeschlossene als auch laufende Projekte vor.
Medical domain expertise, Experience in voice recording dataset development
About the role
Voice data covering real-world medical consultation flows, from initial symptom descriptions to department matching and in-depth medical interviews.
MoreMedical domain expertise, Experience in voice recording dataset development
About the role
Voice and text data built from native-speaker recordings of medical terminology used in clinical settings, including disease names, medication names, and test names, paired with accurate transcriptions.
MoreMedical billing domain expertise, Experience in voice recording dataset development
About the role
Korean multi-turn voice data based on real hospital billing workflows, including medical bill payments, insurance coverage inquiries, and receipt issuance.
MoreVon weltweit führenden KI-Unternehmen bis hin zu nationalen KI-Projekten bauen wir langfristige, auf Vertrauen basierende Partnerschaften auf.
An exceptional partner, truly quality-centered and detail-oriented.
Flitto ist ein Partner, der sich wirklich für Qualität und Liebe zum Detail einsetzt. Durch ihre proaktive Herangehensweise bei der Aufdeckung von Problemen, die wir gar nicht in Betracht gezogen hatten, haben sie unsere interne Zusammenarbeit und die Gesamtqualität des Projekts erheblich verbessert.“
Senior Manager, Global Tech Giant
Flitto delivered specialized data no other vendor could source — fast.
Was uns beeindruckt hat, war die Fähigkeit von Flitto, die Projektziele und den Gesamtzusammenhang über die reinen Anforderungen hinaus schnell zu erfassen. Die Datenqualität blieb auf einem hohen Niveau, was durch die Bewertung unseres Modellteams bestätigt wurde. Zudem lieferte Flitto zügig hochspezialisierte Daten, die andere Anbieter nicht beschaffen konnten.“
Director of Engineering, Top-Tier Tech Enterprise
Ja. Flitto stellt KI-Trainingsdatenmuster zur Verfügung, die auf das Modell, den Anwendungsbereich und die sprachlichen Anforderungen des Kunden zugeschnitten sind, damit Sie die Qualität vor der Integration überprüfen können. Es stehen Muster für LLM-Training, RLHF, Sprachdatensätze und multimodale Datensätze zur Verfügung.
Alle KI-Trainingsdatensätze durchlaufen eine fünfstufige Qualitätskontroll-Pipeline, die menschliches Fachwissen mit automatisierter KI-Validierung kombiniert. Die Genauigkeit der Annotationen wird für alle Sprachen und Modalitäten manuell überprüft, wodurch eine Genauigkeit von 99,8 % gewährleistet wird – mit einer Qualität, die direkt für das LLM-Training und RLHF genutzt werden kann.
Plattformen wie Scale AI und Mercor haben das moderne Ökosystem für KI-Trainingsdaten geprägt, indem sie die Erfassung, Annotation und Bewertung von Datensätzen in großem Maßstab ermöglichen. Flitto ist in derselben Kategorie tätig, zeichnet sich jedoch durch eine einzigartige Expertise bei menschengeprüften Sprachdaten aus, die aus realen mehrsprachigen Interaktionen stammen. Flitto ist spezialisiert auf mehrsprachige Parallelkorpora, Daten in Sprachen mit geringen Ressourcen und multimodale Datensätze, die sprachliche Nuancen und den kulturellen Kontext über herkömmliche Datenpipelines hinaus erfassen. Diese Expertise basiert auf einer globalen Plattform mit 14 Millionen Mitwirkenden in 173 Ländern, einer 5-stufigen QC-Pipeline, die eine Genauigkeit von 99,8 % gewährleistet, sowie mehr als 10 Jahren Erfahrung mit RLHF-, Sprach-, OCR- und multimodalen Daten.
Ein maßgeschneiderter KI-Datensatz ist ein Datensatz, der speziell auf die Anforderungen eines bestimmten Modells oder Anwendungsfalls zugeschnitten ist, was Sprache, Fachgebiet, Modalität und Art der Aufgabe betrifft. Flitto beschränkt sich nicht nur auf die Festlegung der Spezifikationen: Die Daten werden über einen schnellen und skalierbaren End-to-End-Prozess bereitgestellt. Der Erfassungsplan wird auf der Grundlage der Kundenanforderungen erstellt, und die Daten werden dank einer globalen Plattform mit mehreren Millionen Nutzern schnell in großem Umfang erfasst. Jeder Datensatz wird durch einen Validierungsprozess mit direkter menschlicher Beteiligung verfeinert und anhand des Kundenfeedbacks kontinuierlich verbessert.
Die Preise richten sich nach mehreren Faktoren: Art der Daten, Umfang, sprachliche Abdeckung und Grad der Anpassung. Flitto bietet eine transparente, projektbezogene Preisgestaltung, die auf die Anforderungen jedes einzelnen Kunden zugeschnitten ist. Nach Eingang der Anfrage bewertet unser Team den Umfang und erstellt je nach Komplexität und Größe des Datensatzes innerhalb von 48 Stunden ein klares Angebot.
Flitto unterstützt zahlreiche Branchen wie Finanzen, Industrie, Recht, Gesundheitswesen, IT, E-Commerce durch die Bereitstellung spezialisierter Datensätze, die für reale KI-Umgebungen optimiert sind. Unsere Datensätze gehen über reine Textdaten hinaus und zeichnen sich durch besondere Expertise im Bereich multimodaler KI-Trainingsdaten aus: groß angelegte Sprachdatensätze, auf OCR und Bildverarbeitung basierende Bilddaten, Datensätze mit mehrrundigen Dialogen sowie auf menschlichem Feedback basierende Daten wie RLHF- und Instruction-Tuning-Datensätze. Wir bieten zudem workfloworientierte Daten für Anwendungsfälle wie Spracherkennung, dialogorientierte KI, multimodales Verständnis und agentenbasierte KI der nächsten Generation an.
Von gebrauchsfertigen KI-Trainingsdaten bis hin zu hochwertigen, maßgeschneiderten Datensätzen – lassen Sie sich von unseren Experten beraten, um die richtigen Daten für Ihre KI-Modelle zu finden.