Datos fundacionales
Recolectamos datos multimodales y multilingües de texto, voz e imagen, diseñados especialmente para el entrenamiento de modelos fundacionales de IA.
Capturing the Real World Data AI has been Missing.
Maximizamos el rendimiento de los LLM con datos de entrenamiento multilingües y multimodales verificados por expertos humanos. Gracias a nuestro proceso de calidad de cinco etapas, garantizamos una precisión del 99.8% y datos 100% libres de problemas de derechos de autor.
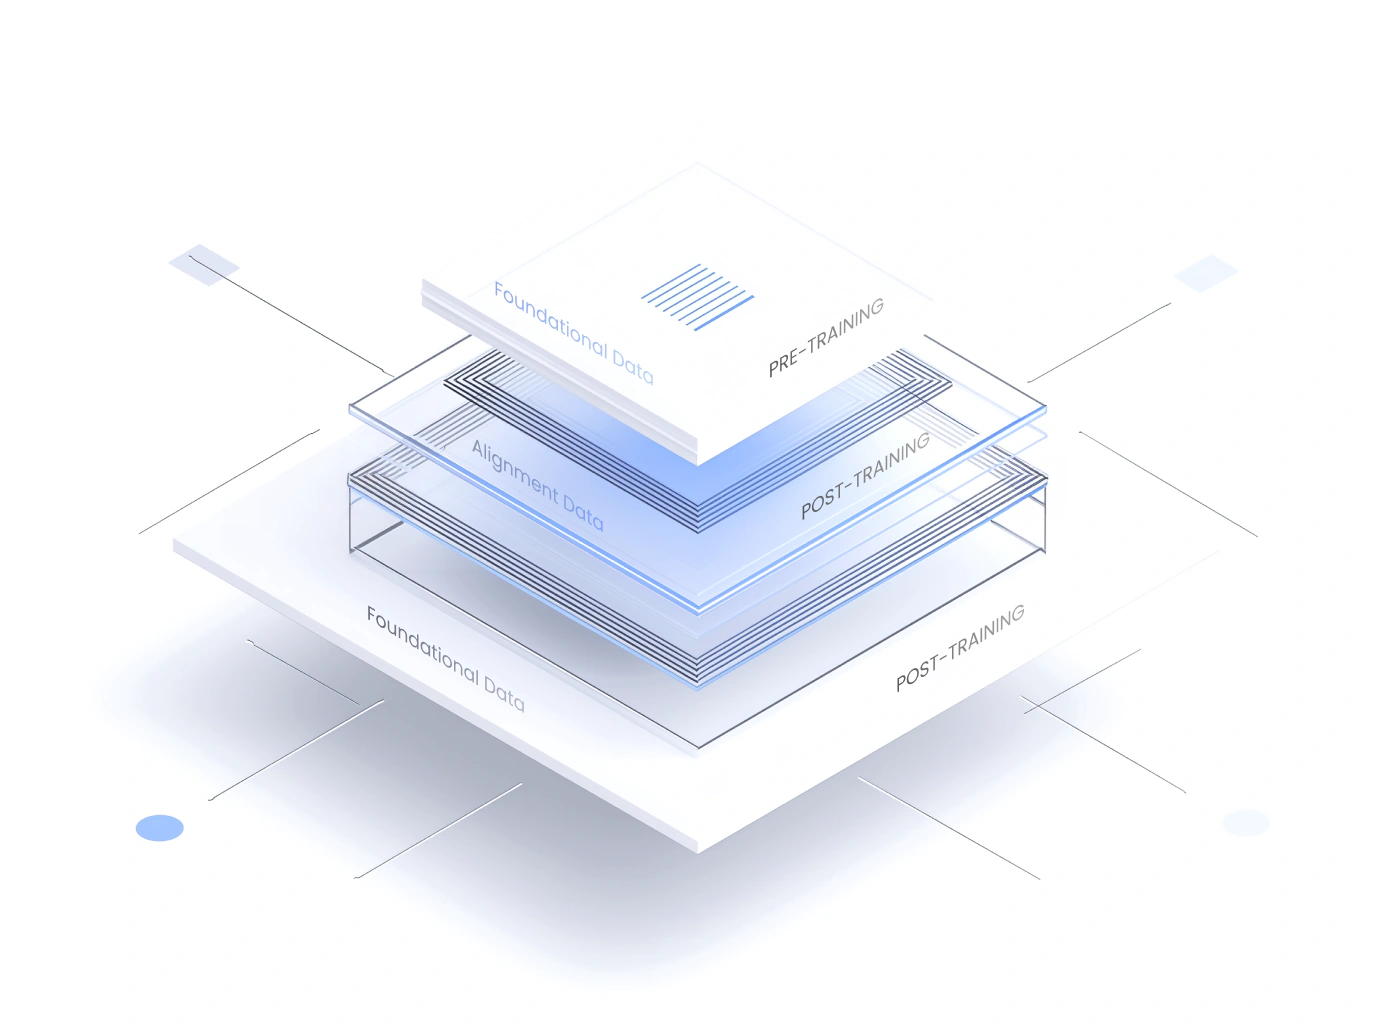
Flitto impulsa el desarrollo de la IA con una plataforma de datos multifásicos y multimodales en varios idiomas. Cubrimos cada etapa del proceso de IA, manejando con eficacia diversos tipos de datos, como texto, imágenes, audio y video, para que los modelos de IA funcionen de forma óptima en distintos idiomas y mercados globales.


Desde el preentrenamiento hasta el posentrenamiento
Recolectamos datos multimodales y multilingües de texto, voz e imagen, diseñados especialmente para el entrenamiento de modelos fundacionales de IA.
Alineamos el modelo con las intenciones y valores humanos mediante RLHF, diálogos de múltiples turnos y datos de seguridad.
Impulsamos los límites de los modelos de IA de frontera con conjuntos de datos de codificación, CoT y referencias de primer nivel.
Flitto colabora con expertos de diversas áreas para recopilar y generar datos de entrenamiento de IA, presentando tanto proyectos terminados como en curso.
Medical domain expertise, Experience in voice recording dataset development
About the role
Voice data covering real-world medical consultation flows, from initial symptom descriptions to department matching and in-depth medical interviews.
MoreMedical domain expertise, Experience in voice recording dataset development
About the role
Voice and text data built from native-speaker recordings of medical terminology used in clinical settings, including disease names, medication names, and test names, paired with accurate transcriptions.
MoreMedical billing domain expertise, Experience in voice recording dataset development
About the role
Korean multi-turn voice data based on real hospital billing workflows, including medical bill payments, insurance coverage inquiries, and receipt issuance.
MoreDesde empresas globales de IA hasta proyectos nacionales, construimos alianzas a largo plazo basadas en la confianza.
An exceptional partner, truly quality-centered and detail-oriented.
Flitto es un socio comprometido con la calidad y la atención a los detalles. Su enfoque proactivo para identificar puntos que ni siquiera habíamos considerado mejoró significativamente nuestra colaboración interna y la calidad final del proyecto".
Senior Manager, Global Tech Giant
Flitto delivered specialized data no other vendor could source — fast.
Lo que más nos impresionó de Flitto fue la rapidez con la que captaron no solo los requisitos del proyecto, sino también los objetivos generales. La calidad de los datos mantuvo un alto estándar en las evaluaciones de nuestro equipo de modelos y, cuando necesitamos datos altamente especializados que otros proveedores no podían conseguir, Flitto los entregó rápidamente".
Director of Engineering, Top-Tier Tech Enterprise
Sí. En Flitto ofrecemos muestras de datos de entrenamiento para IA adaptadas a su modelo, dominio y requisitos de idioma, para que pueda validar la calidad antes de comenzar. Contamos con muestras para entrenamiento de LLM, RLHF, conjuntos de datos de voz y multimodales.
Todos nuestros datos de entrenamiento para IA pasan por un proceso de control de calidad de 5 etapas que combina la revisión de expertos con validación asistida por IA. Garantizamos una precisión del 99.8% verificada por humanos en todos los idiomas y modalidades, ofreciendo una calidad lista para implementarse de inmediato en flujos de trabajo de entrenamiento de LLM y RLHF.
Las plataformas de datos de IA como Scale AI y Mercor han impulsado el ecosistema moderno de datos de entrenamiento, permitiendo a los equipos obtener, etiquetar y evaluar grandes conjuntos de datos para el desarrollo de modelos. Flitto opera en esta misma categoría, destacándose por su enfoque en datos lingüísticos verificados por humanos a partir de interacciones multilingües reales. Nos especializamos en corpus paralelos multilingües, datos de idiomas de bajos recursos y conjuntos de datos multimodales que capturan matices lingüísticos y contextos culturales que los flujos de datos convencionales pasan por alto. Estas capacidades se apoyan en nuestra plataforma global de 14 millones de usuarios en 173 países, un proceso de control de calidad de cinco pasos con una precisión del 99.8% y más de diez años de experiencia en RLHF, voz, OCR y datos multimodales.
Los datos personalizados para IA se crean para satisfacer los requisitos específicos de un modelo o caso de uso, incluyendo idioma, dominio, modalidad y tipo de tarea. En Flitto, vamos más allá del diseño de especificaciones: entregamos los datos a través de un proceso integral, rápido y escalable. Diseñamos una estrategia de recolección basada en tus objetivos y aprovechamos nuestra plataforma global de millones de usuarios para obtener datos a gran escala de forma ágil. Cada conjunto de datos se perfecciona mediante una validación humana (human-in-the-loop) y se mejora continuamente con los comentarios del cliente.
El precio se determina según factores como el tipo de datos, el volumen, la cobertura lingüística y el nivel de personalización. Flitto ofrece tarifas transparentes y adaptadas a los requisitos de su proyecto. Una vez recibida su solicitud, nuestro equipo revisará el alcance y le entregará una cotización clara en un plazo de 48 horas, dependiendo de la complejidad y escala del conjunto de datos.
Flitto ofrece servicios para una amplia variedad de sectores, incluyendo finanzas, manufactura, legal, salud, informática y comercio electrónico, ofreciendo conjuntos de datos especializados y optimizados para aplicaciones de IA en el mundo real. Nuestros conjuntos de datos van más allá del texto convencional, con un fuerte enfoque en el entrenamiento de IA multimodal. Esto incluye datasets de voz a gran escala, datos de imagen basados en OCR y visión, conversaciones multiturno y datos basados en retroalimentación humana, como RLHF y ajuste de instrucciones. También proporcionamos datos orientados a flujos de trabajo diseñados para sistemas de IA avanzados, permitiendo casos de uso como reconocimiento de voz, IA conversacional, comprensión multimodal e IA agéntica de próxima generación.
Desde datos de entrenamiento listos para usar hasta datos personalizados de alta calidad, hable con nuestros expertos para encontrar los datos ideales para sus modelos de IA.