Données fondamentales
Collecter et envoyer des données textuelles, vocales et visuelles multilingues et multimodales, conçues pour l'entraînement fondamental de l'IA
Capturing the Real World Data AI has been Missing.
Données d'entraînement IA multilingues et multimodales, vérifiées par des experts humains pour optimiser les performances des LLM. Continuellement affinées grâce à un pipeline qualité en cinq étapes, garantissant une précision de 99,8 % avec des données 100 % protégées par les droits d'auteur.
Flitto propulse le développement de l'IA en tant que plateforme Multi-Phase, Multi-Modale et Multi-Linguale — soutenant chaque étape du pipeline IA, gérant de manière fluide des types de données variés incluant texte, images, audio et vidéo, et permettant aux modèles d'IA d'être performants dans toutes les langues et sur les marchés mondiaux.


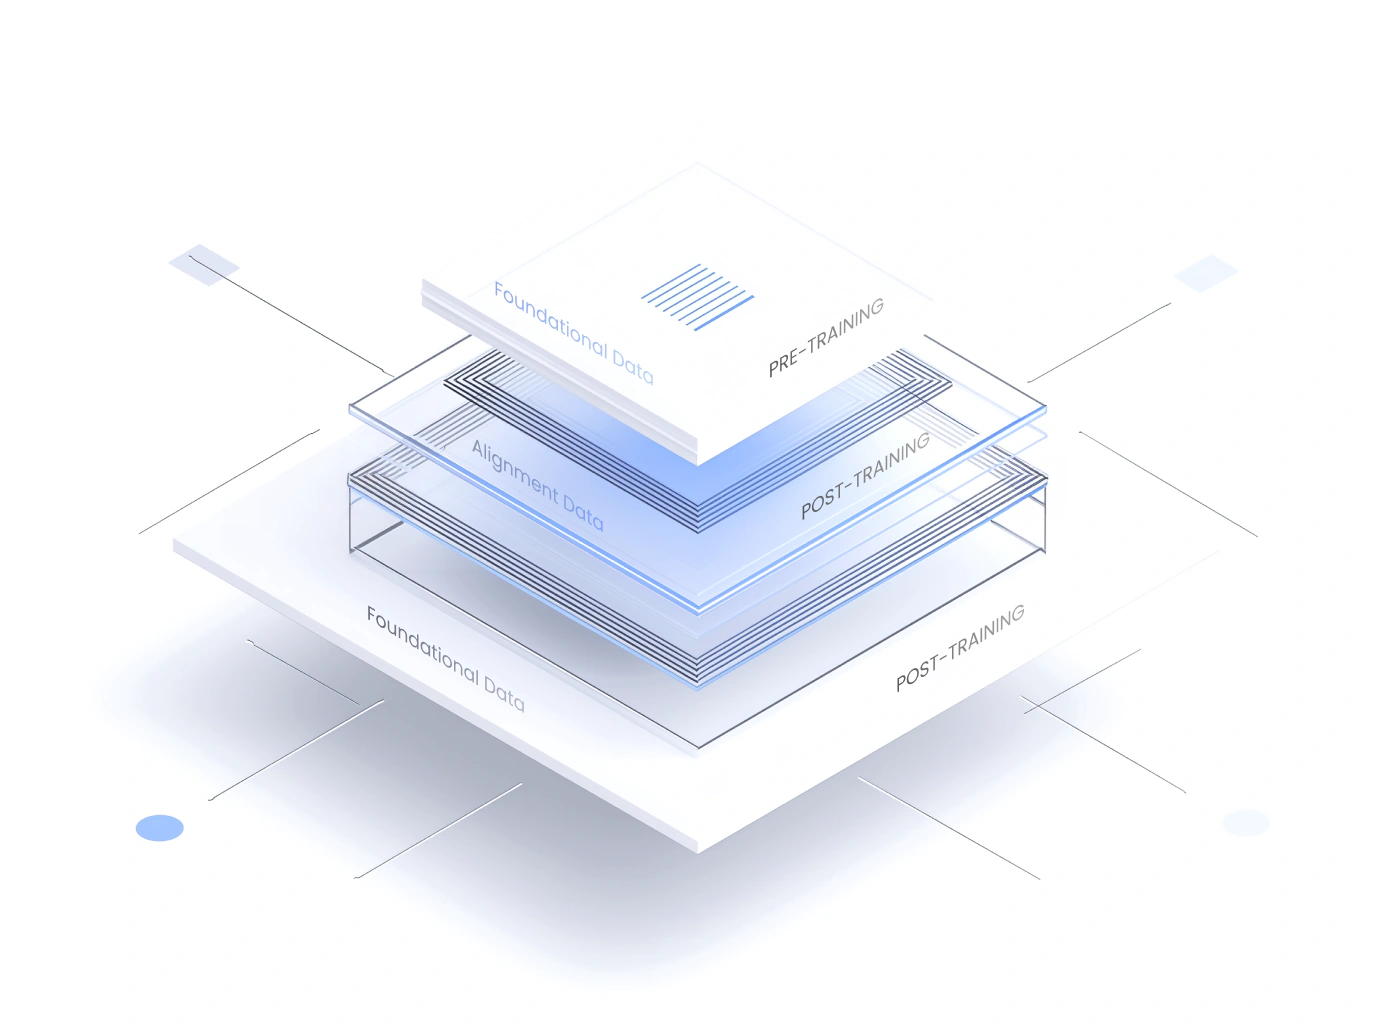
Des Données de pré-entraînement jusqu'aux données de post-entraînement
Collecter et envoyer des données textuelles, vocales et visuelles multilingues et multimodales, conçues pour l'entraînement fondamental de l'IA
Données RLHF, de dialogue multi-tours et de sécurité, alignées sur les intentions et les valeurs humaines.
Benchmarks de pointe, données CoT et jeux de données de codage, conçus pour repousser les limites des modèles d'IA frontier.
Flitto recrute des experts issus de domaines variés pour mener des projets de collecte et de constitution de données d'entraînement IA. Découvrez l'ensemble des projets achevés et en cours.
Medical domain expertise, Experience in voice recording dataset development
About the role
Voice data covering real-world medical consultation flows, from initial symptom descriptions to department matching and in-depth medical interviews.
MoreMedical domain expertise, Experience in voice recording dataset development
About the role
Voice and text data built from native-speaker recordings of medical terminology used in clinical settings, including disease names, medication names, and test names, paired with accurate transcriptions.
MoreMedical billing domain expertise, Experience in voice recording dataset development
About the role
Korean multi-turn voice data based on real hospital billing workflows, including medical bill payments, insurance coverage inquiries, and receipt issuance.
MoreDes grandes entreprises IA mondiales aux projets IA nationaux, nous construisons des partenariats durables fondés sur la confiance.
An exceptional partner, truly quality-centered and detail-oriented.
Flitto est un partenaire véritablement engagé dans la qualité et le souci du détail. Grâce à leur capacité à anticiper des aspects auxquels nous n'avions pas pensé, nous avons pu améliorer la collaboration interne et la qualité globale de nos projets."
Senior Manager, Global Tech Giant
Flitto delivered specialized data no other vendor could source — fast.
Ce qui nous a impressionnés, c'est la capacité de Flitto à saisir rapidement les objectifs du projet et la vue d'ensemble, au-delà des simples exigences. La qualité des données a maintenu un niveau élevé, confirmé par l'évaluation de notre équipe modèle. Flitto a aussi livré rapidement des données hautement spécialisées que d'autres fournisseurs n'avaient pas été en mesure de sourcer."
Director of Engineering, Top-Tier Tech Enterprise
Oui. Flitto fournit des échantillons de données d'entraînement IA adaptés au modèle, au domaine et aux exigences linguistiques du client, afin que vous puissiez vérifier la qualité avant toute intégration. Des échantillons sont disponibles pour l'entraînement LLM, le RLHF, les datasets vocaux et les datasets multimodaux.
Tous les datasets d'entraînement IA passent par un pipeline QC en 5 étapes combinant expertise humaine et validation automatisée par IA. La précision des annotations est vérifiée manuellement sur l'ensemble des langues et modalités, garantissant 99,8 % de précision, avec une qualité directement exploitable pour l'entraînement LLM et le RLHF.
Des plateformes comme Scale AI et Mercor ont façonné l'écosystème moderne des données d'entraînement IA en permettant la collecte, la labelisation et l'évaluation de datasets à grande échelle. Flitto opère dans la même catégorie, mais se distingue par une expertise différenciée dans les données linguistiques vérifiées par des humains et issues d'interactions multilingues réelles. Flitto se spécialise dans les corpus parallèles multilingues, les données en langues à faibles ressources, et les datasets multimodaux capturant les nuances linguistiques et le contexte culturel, au-delà des pipelines de données classiques. Cette expertise repose sur une plateforme mondiale de 14 millions de contributeurs dans 173 pays, un pipeline QC en 5 étapes garantissant 99,8 % de précision, et plus de 10 ans d'expérience couvrant les données RLHF, vocales, OCR et multimodales.
Un dataset IA sur mesure est un dataset conçu pour répondre aux exigences d'un modèle ou d'un cas d'usage spécifique, en termes de langue, de domaine, de modalité et de type de tâche. Flitto ne se limite pas à la définition des spécifications : les données sont livrées via un processus end-to-end rapide et évolutif. Le plan de collecte est élaboré à partir des exigences du client, et les données à grande échelle sont collectées rapidement grâce à une plateforme mondiale de plusieurs millions d'utilisateurs. Chaque dataset est affiné par un processus de validation avec intervention humaine directe, et continuellement amélioré en fonction des retours clients.
Les tarifs sont déterminés en fonction de plusieurs facteurs : type de données, volume, couverture linguistique et niveau de personnalisation. Flitto propose une politique tarifaire transparente par projet, adaptée aux exigences de chaque client. Une fois la demande reçue, notre équipe évalue le périmètre et fournit un devis clair dans un délai de 48 heures, selon la complexité et l'envergure du dataset.
Flitto accompagne de nombreux secteurs — finance, industrie, juridique, santé, IT, e-commerce — en fournissant des datasets spécialisés optimisés pour les environnements IA réels. Nos datasets vont au-delà du texte, avec une expertise marquée dans les données d'entraînement IA multimodales : datasets vocaux à grande échelle, données images basées sur l'OCR et la vision, datasets de dialogues multi-tours, et données basées sur le feedback humain telles que les datasets RLHF et d'instruction tuning. Nous proposons également des données orientées workflow pour des cas d'usage tels que la reconnaissance vocale, l'IA conversationnelle, la compréhension multimodale et l'IA agentique de nouvelle génération.
Des données d'entraînement IA prêts à l'emploi aux datasets personnalisés de haute qualité — consultez nos experts pour trouver les données adaptées à votre modèle IA.