Фундаментальные данные
Мы собираем и поставляем многоязычные и мультимодальные текстовые, аудио- и графические данные, которые служат фундаментом для обучения ИИ.
Capturing the Real World Data AI has been Missing.
Многоязычные и мультимодальные данные для обучения LLM на разных языках, прошедшие проверку человеком. Непрерывная очистка данных в рамках пятиэтапного цикла контроля качества с точностью 99,8%. Полное отсутствие нарушений авторских прав.
Flitto — многоэтапная мультимодальная и многоязычная платформа для комплексной разработки ИИ. Мы поддерживаем весь ИИ-конвейер и обеспечиваем бесшовную обработку текста, изображений, аудио и видео, помогая моделям достигать максимальной производительности на разных языках и рынках.


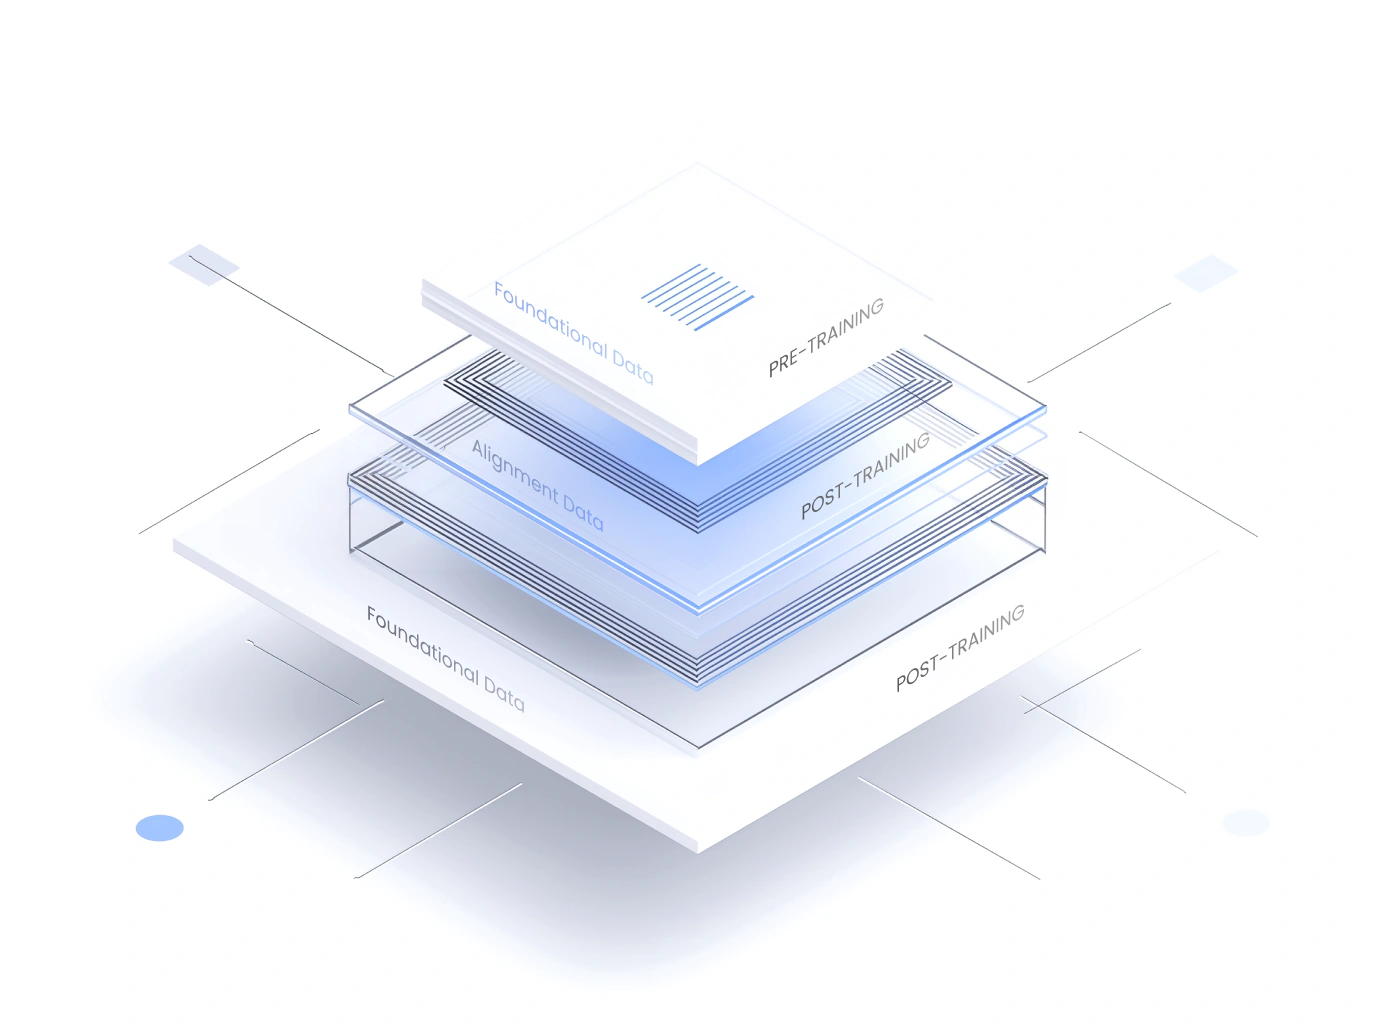
От данных для предварительного обучения до этапа послеобучения
Мы собираем и поставляем многоязычные и мультимодальные текстовые, аудио- и графические данные, которые служат фундаментом для обучения ИИ.
Мы помогаем моделям лучше соответствовать человеческим намерениям и ценностям с помощью RLHF, многоходовых диалогов и данных по безопасности.
Мы расширяем возможности передовых ИИ-моделей с помощью высокоуровневых бенчмарков, CoT-данных и данных для программирования.
Flitto привлекает экспертов из разных областей для сбора и подготовки обучающих данных для ИИ. Ниже представлены наши завершенные и текущие проекты.
Medical domain expertise, Experience in voice recording dataset development
About the role
Voice data covering real-world medical consultation flows, from initial symptom descriptions to department matching and in-depth medical interviews.
MoreMedical domain expertise, Experience in voice recording dataset development
About the role
Voice and text data built from native-speaker recordings of medical terminology used in clinical settings, including disease names, medication names, and test names, paired with accurate transcriptions.
MoreMedical billing domain expertise, Experience in voice recording dataset development
About the role
Korean multi-turn voice data based on real hospital billing workflows, including medical bill payments, insurance coverage inquiries, and receipt issuance.
MoreНам доверяют мировые технологические компании и команды национальных ИИ-проектов. Мы строим долгосрочные партнерские отношения, основанные на доверии.
An exceptional partner, truly quality-centered and detail-oriented.
Flitto демонстрирует исключительное внимание к качеству и деталям. Их проактивность в выявлении скрытых нюансов помогла нам оптимизировать внутренние процессы и добиться высокого уровня исполнения проекта."
Senior Manager, Global Tech Giant
Flitto delivered specialized data no other vendor could source — fast.
Нас впечатлило, как быстро Flitto схватывает общую картину и цели проекта, выходя далеко за рамки простых инструкций. Качество данных неизменно получало высокие оценки нашей команды разработчиков, а те специфические и сложные наборы данных, с которыми не справлялись другие вендоры, Flitto поставляла оперативно и точно."
Director of Engineering, Top-Tier Tech Enterprise
Да. Flitto предоставляет образцы обучающих данных, адаптированные под конкретную модель, домен и языковые требования заказчика. Это позволяет заранее оценить качество данных перед их внедрением. Мы предлагаем образцы для обучения LLM, RLHF, голосовых наборов данных и мультимодальных проектов.
Все наборы данных для обучения ИИ проходят пятиэтапный цикл контроля качества: от ИИ-валидации до экспертной проверки. Мы обеспечиваем точность аннотаций на уровне 99,8% за счет прямой проверки человеком для всех языков и модальностей. В результате заказчик получает данные, полностью готовые к немедленному использованию в обучении LLM и процессах RLHF.
Такие платформы, как Scale AI и Mercor, сформировали современную экосистему данных, обеспечив масштабный сбор и разметку. Flitto работает в той же категории, но отличается глубокой экспертизой в верификации лингвистических данных, основанной на реальном многоязычном взаимодействии. Мы специализируемся на создании параллельных корпусов, данных для редких языков и мультимодальных наборов, где учитываются лингвистические нюансы и культурный контекст. Наша ключевая сила — глобальная платформа с 14 млн пользователей из 173 стран, пятиэтапный цикл контроля качества с точностью 99,8% и более чем 10-летний опыт работы с RLHF, аудиоданными, OCR и мультимодальными решениями.
Это набор данных, созданный под конкретные требования модели или сценария использования, включая язык, домен, модальность и тип задачи. В Flitto разработка кастомных наборов данных не сводится к простому выполнению спецификаций. Мы обеспечиваем быструю и масштабируемую end-to-end поставку: на основе требований клиента формируем план сбора данных и задействуем нашу глобальную платформу с миллионами пользователей, чтобы оперативно создавать массивы данных нужного объема. Каждый набор проходит тщательную очистку и валидацию с участием человека, а затем дорабатывается с учетом обратной связи клиента.
Стоимость зависит от типа данных, их объема, языкового охвата и уровня кастомизации. Flitto использует прозрачную проектную модель ценообразования, адаптированную под задачи и требования каждого заказчика. После получения запроса наша команда оценивает масштаб и сложность проекта, а затем в течение 48 часов предоставляет подробное коммерческое предложение с учетом объема и специфики требуемого набора данных.
Flitto работает с широким спектром отраслей, включая финансы, производство, юриспруденцию, медицину, ИТ и электронную коммерцию. Мы предоставляем специализированные наборы данных, адаптированные для реальных сценариев применения ИИ. Наши возможности не ограничиваются текстовыми данными. Мы также специализируемся на мультимодальных данных для обучения ИИ: масштабных наборах голосовых данных, изображениях для OCR и компьютерного зрения, многоходовых диалогах, а также данных на основе человеческой обратной связи, включая наборы для RLHF и Instruction Tuning. Кроме того, мы предлагаем данные, ориентированные на рабочие процессы и прикладные сценарии: распознавание речи, диалоговый ИИ, мультимодальное понимание и агентный ИИ нового поколения.
Проконсультируйтесь с экспертом по подбору данных для вашей модели: от готовых до высококачественных кастомных наборов данных.