基础数据
将以AI学习为基础的文本、语音和图片数据,通过多语言·多模态的处理方式进行收集与交付。
Capturing the Real World Data AI has been Missing.
以多语言·多模态为基础的人类检验AI学习数据,最大化提升LLM性能。通过五阶段的质检流程持续优化,提供准确率高达99.8%并且100%无版权问题的数据。
Flitto作为Multi-Phase、Multi-Modal、Multi-Lingual平台,全方位支持AI开发。全面覆盖AI流程的各个阶段,实现文本·图片·音频·视频等多类型数据的无缝处理,助力AI模型在全球多语言及各种市场环境中发挥出卓越性能。


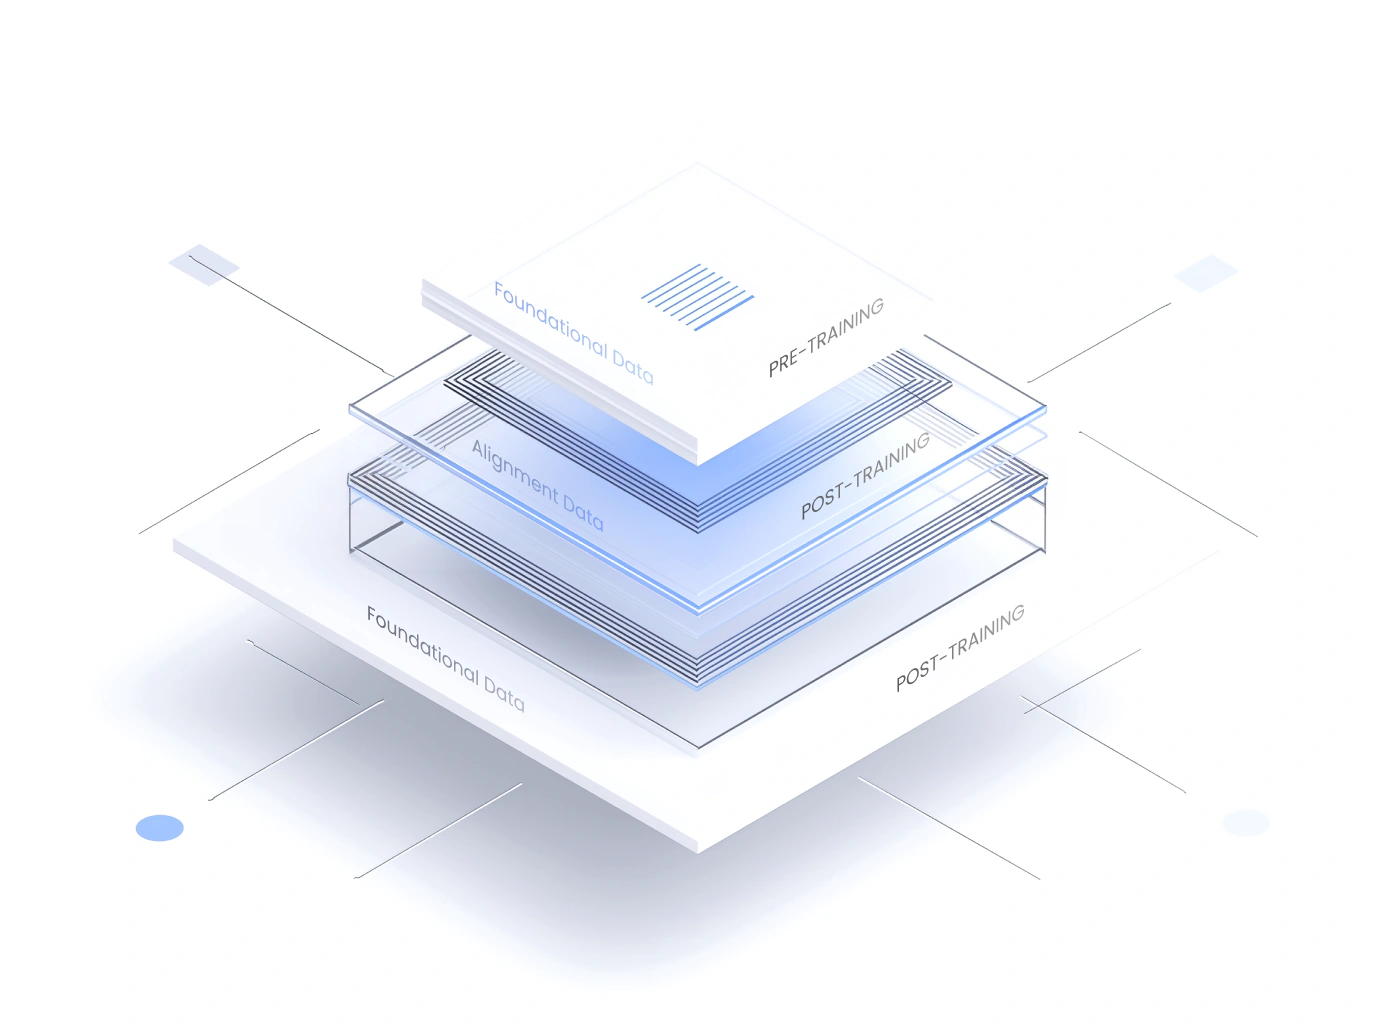
从Pre-training数据到Post-training数据
将以AI学习为基础的文本、语音和图片数据,通过多语言·多模态的处理方式进行收集与交付。
通过RLHF、多轮对话、Safety数据让模型与人类的意图和价值观精准对齐。
依托高质量的基准检测·CoT·代码数据,不断拓展前沿AI模型的性能极限。
Flitto招募各领域专家,执行AI学习数据的收集与构建项目。为您介绍已完成的项目和正在进行的项目。
具备医疗领域知识的人员, 具备语音录音数据构建经验的人员
About the role
收集覆盖患者从初步症状陈述、专业诊疗及匹配到深度问诊的实际医疗咨询流程语音数据。
查看更多具备医疗领域知识的人员, 具备语音录音数据构建经验的人员
About the role
收集并高精度转写医疗场景中实际使用的疾病名称、药物名称及检查项目等专业术语的母语发音,并同步收集语音·文本数据。
查看更多具备医疗领域知识的人员(结算相关), 具备语音录音数据构建经验的人员
About the role
收集在医院缴费窗口环境下,包含医疗费支付、保险使用咨询及开具发票等实际缴费流程的韩语多轮对话语音数据。
查看更多从全球AI企业到国家级AI项目,我们以信赖为基础,持续建立长期的合作关系。
An exceptional partner, truly quality-centered and detail-oriented.
Flitto是一家极度重视质量与细节的合作伙伴,总能提前发现我们未曾注意到的问题,从而提升内部协作效率与项目完成质量。”
Senior Manager, Global Tech Giant
Flitto delivered specialized data no other vendor could source — fast.
令我印象深刻的有,Flitto不仅理解了表面需求,更快速把握住了项目的目标与整体蓝图。在我方模型团队的评估中,数据质量始终保持高水平,同时对于其他供应商难以获取的高度专业数据,Flitto仍能实现快速交付。”
Director of Engineering, Top-Tier Tech Enterprise
可以。Flitto将为客户公司提供符合模型、领域及语言需求的AI学习数据样本,可在导入前进行质量检验。我们会提供LLM学习、RLHF、语音数据集与多模态数据集的样本数据。
所有AI学习数据集均通过由专家审核与AI自动检验相结合的五阶段QC流程。针对全部语言及模态,通过人工直接验证,确保标注准确率达到99.8%,并提供可即刻投入LLM学习与RLHF的高质量数据。
Scale AI、Mercor之类的AI数据平台,实现了大规模数据集的收集·标注·评估,并持续引领着现代AI学习数据的生态发展。Flitto也在相同的业务领域运营,但在以实际多语言交互为基础,由人工直接检验的语言数据方面,具备了独特的差异化能力。我们专门提供多语言平行语料与低资源语言数据,并构建超越传统数据流程,能够捕捉语言细微差异及文化语境的多模态数据集。该核心能力建立在173个国家、1400万人规模的全球众包网络平台之上,并结合了高达99.8%准确度的五阶段QC流程,以及在RLHF·语音·OCR和多模态数据领域10年以上的深厚经验。
AI定制数据集是针对特定模型或使用场景需求,在语言、领域、模态及任务类型等维度构建的数据集。Flitto不止步于规格定义,更通过快速且可扩展的端到端流程,实现数据的最终交付。我们根据客户公司的需求设计数据收集计划,并利用规模达数百万人的全球平台,快速收集大规模数据。每一个数据集都经过人工亲自参与检验来进行优化,并会根据客户的反馈不断改进。
价格取决于数据类型、规模、语言覆盖范围及定制化程度等因素。Flitto为客户公司提供透明的项目制价格体系。收到需求后,我们将快速评估项目范围,并根据数据集复杂度与规模,在48小时内给出准确报价。
Flitto支持金融、制造、法律、医疗、IT及电商等多行业领域,提供面向实际AI应用场景优化的领域定制数据集。我们的数据集不止于文本,更在多模态AI学习数据方面展现出了核心优势。覆盖大规模语音数据集、OCR及视觉图片数据、多轮对话数据集,并包含基于人类反馈的RLHF·指令微调数据集。此外,我们还提供以工作流为导向的数据,覆盖语音识别、对话式AI、多模态理解及新一代代理式AI等应用场景的支持。
从即用型AI学习数据到高质量定制数据集,可通过专家咨询服务,为您的AI模型量身打造专属的数据方案。