基礎數據
將以AI學習為基礎的文字、語音和圖片資料,透過多語言、多模態的處理方式進行收集與交付。
Capturing the Real World Data AI has been Missing.
以多語言、多模態為基礎的人類檢驗AI學習資料,最大化提升LLM效能。透過五階段的品質檢測流程持續改善,提供準確率高達99.8%、並且100%無版權問題的數據資料。
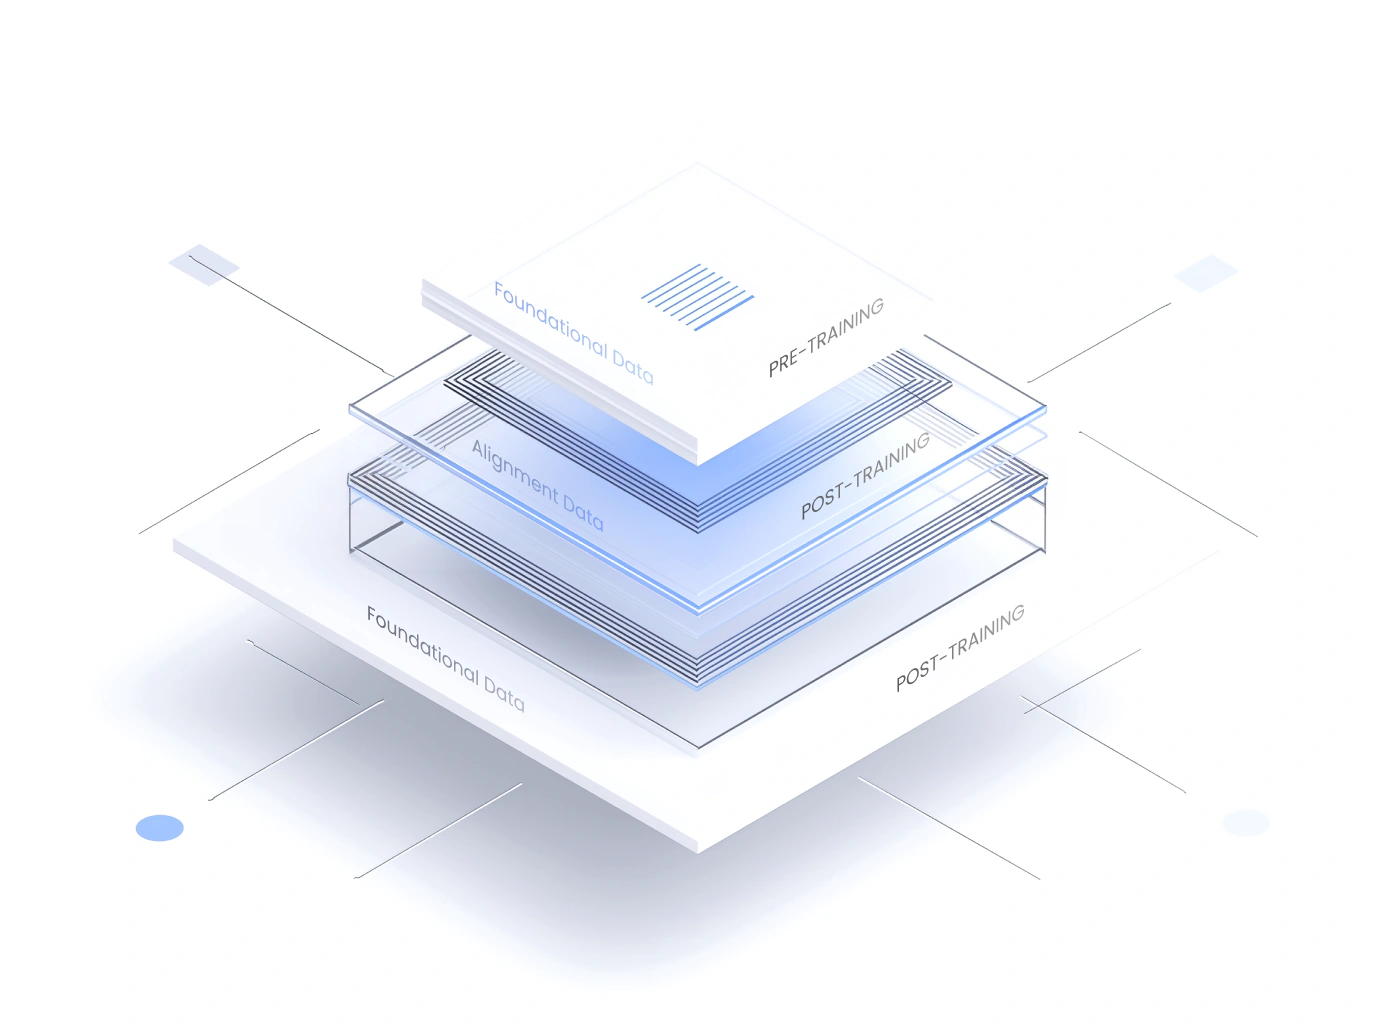
Flitto作為Multi-Phase、Multi-Modal、Multi-Lingual平台,全方位支持AI開發。完整涵蓋AI流程的各個階段,實現文字·圖片·音訊·影片等多類型資料的無縫處理,協助AI模型在全球多語言及各種市場環境中發揮卓越效能。


從Pre-training資料到Post-training資料
將以AI學習為基礎的文字、語音和圖片資料,透過多語言、多模態的處理方式進行收集與交付。
透過RLHF、多輪對話、Safety資料,讓模型與人類的意圖及價值觀精準對齊。
依託高品質的基準檢測、CoT、程式碼資料,不斷拓展前沿AI模型的效能極限。
Flitto招募各領域專家,執行AI學習資料的收集與建置專案。為您介紹已完成的專案及正在進行的專案。
Medical domain expertise, Experience in voice recording dataset development
About the role
Voice data covering real-world medical consultation flows, from initial symptom descriptions to department matching and in-depth medical interviews.
MoreMedical domain expertise, Experience in voice recording dataset development
About the role
Voice and text data built from native-speaker recordings of medical terminology used in clinical settings, including disease names, medication names, and test names, paired with accurate transcriptions.
MoreMedical billing domain expertise, Experience in voice recording dataset development
About the role
Korean multi-turn voice data based on real hospital billing workflows, including medical bill payments, insurance coverage inquiries, and receipt issuance.
More從全球AI企業到國家級AI專案,我們以信任為基礎,持續建立長期的合作關系。
An exceptional partner, truly quality-centered and detail-oriented.
Flitto是一家極度重視品質與細節的合作夥伴,總能提前發現我們未曾注意到的問題,從而提升內部協作效率與專案完成品質。」
Senior Manager, Global Tech Giant
Flitto delivered specialized data no other vendor could source — fast.
令我印象深刻的是,Flitto不僅理解了表面需求,更快速掌握了專案目標與整體藍圖。在我方模型團隊的評估中,資料品質始終保持高水準,同時對於其他供應商難以獲取的高度專業資料,Flitto仍能實現快速交付。」
Director of Engineering, Top-Tier Tech Enterprise
可以。Flitto將為客戶公司提供符合模型、領域及語言需求的AI學習資料樣本,可在導入前進行品質檢驗。我們會提供LLM學習、RLHF、語音資料集與多模態資料集的樣本資料。
所有AI學習資料集皆通過由專家審核與AI自動檢驗相結合的五階段QC流程。針對所有語言及模態,透過人工直接驗證,確保標註準確率達到99.8%,並提供可即刻投入LLM學習與RLHF的高品質資料。
Scale AI、Mercor之類的AI資料平台,實現了大規模資料集的收集、標註與評估,並持續引領現代AI學習資料的生態發展。Flitto也相同深耕此業務領域,但在以實際多語言互動為基礎,由人工直接檢驗的語言資料方面,具備了獨特的差異化能力。我們專門提供多語言平行語料與低資源語言資料,並建置超越傳統資料流程,能夠捕捉語言細微差異及文化語境的多模態資料集。此核心能力建立在173個國家、1400萬人規模的全球網路平台之上,並結合了高達99.8%準確度的五階段QC流程,以及在RLHF、語音、OCR和多模態資料領域有超過10年的深厚經驗。
AI客製化資料集是針對特定模型或使用情境需求,在語言、領域、模態及任務類型等面相所建置的資料集。Flitto不僅止於規格定義,更透過快速且可擴展的端到端流程,實現資料的最終交付。我們會根據客戶公司的需求設計資料收集計劃,並利用規模達數百萬人的全球平台,快速收集大規模資料。每一個資料集都經過人工親自參與檢驗來進行改善,並根據客戶的回饋不斷改進。
價格取決於資料類型、規模、語言涵蓋範圍及客製化程度等因素。Flitto為客戶公司提供透明的專案制價格體系。收到需求後,我們將快速評估專案範圍,並根據資料集的複雜度與規模,在48小時內提供準確報價。
Flitto支援金融、製造、法律、醫療、IT及電商等多個產業領域,提供針對實際AI應用情境的領域客製化資料集。我們的資料集不僅限於文字,更在多模態AI學習資料方面展現核心優勢。涵蓋大規模語音資料集、OCR及視覺圖片資料、多輪對話資料集,並包含基於人類回饋的RLHF、指令微調資料集。此外,我們也提供以工作流為導向的資料,支援語音辨識、對話式AI、多模態理解及新一代代理式AI等應用情境。
從即用型AI學習資料到高品質客製化資料集,可透過專家諮詢服務,為您的AI模型量身打造專屬的資料方案。